Una mail che in casella non c'era
Ho un assistente AI personale. Ogni mattina, poco dopo le sei, mi manda un riepilogo: la posta non letta, gli appuntamenti del giorno, le cose rimaste aperte, lo stato dei sistemi che tengo in piedi. Lo leggo prima del caffè.
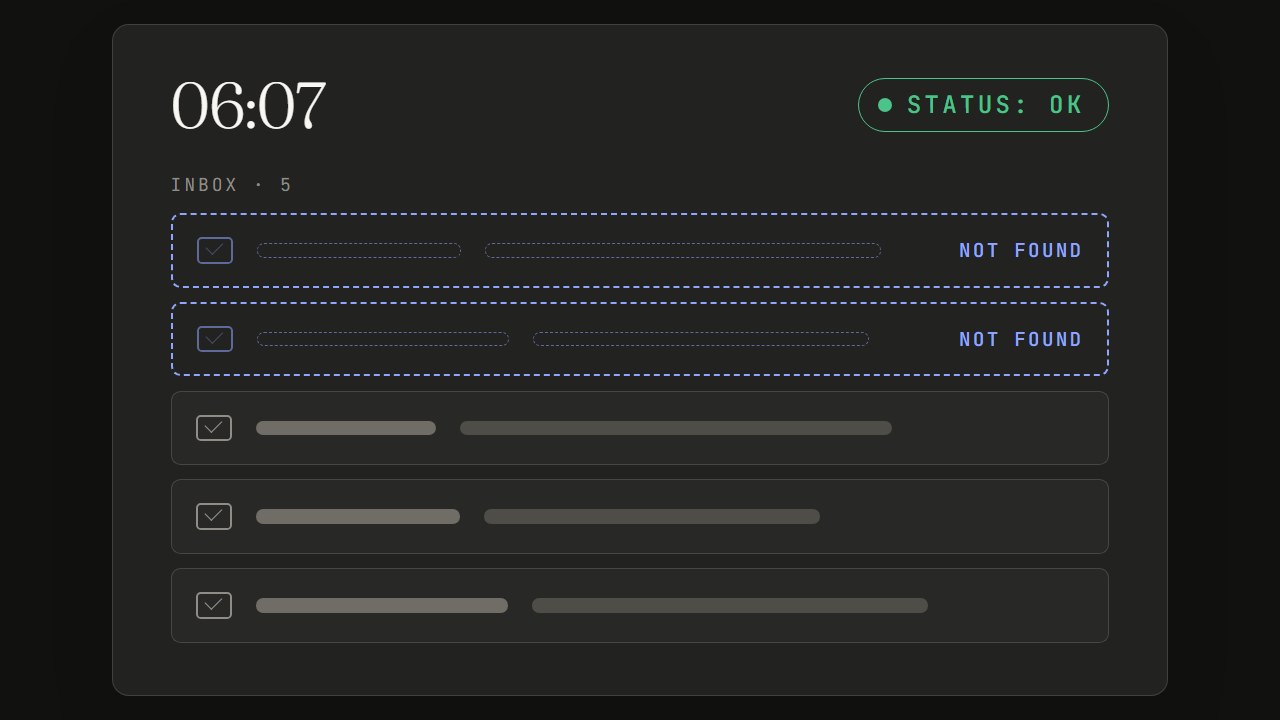
La mattina del 27 luglio 2026, fra la posta non letta, c'erano due mail da mittenti che non avevo mai visto. Una parlava di un servizio che uso davvero, con un oggetto del tutto plausibile. L'ho cercata in casella e non c'era. L'ho cercata dappertutto, spam e cestino compresi. Niente.
Quella mail non era mai esistita. Le non lette vere erano tre, vecchie di settimane, tutte dello stesso mittente automatico. Il modello aveva pescato il nome di quel servizio dalle proprie istruzioni, dove c'erano le regole per gestire le sue notifiche, e ci aveva cucito intorno un mittente e un oggetto verosimili.
Fin qui sembra la solita storia dell'AI che inventa. La parte interessante è venuta dopo, quando ho cercato il perché: ricostruendo all'indietro, i dati falsi andavano avanti da giorni.
Tre guasti, uno sopra l'altro
Sotto c'erano tre guasti indipendenti. Nessuno dei tre si vedeva da fuori. Insieme producevano un riepilogo che sembrava normale.
stato: ok Il riepilogo arriva ogni mattina, ben formattato
- 01L'accesso alla posta è scadutoPosta e calendario non si leggono più
- 02Lo script che li legge è stato riscritto a metàAnche con l'accesso buono, non legge niente
- 03Le istruzioni chiedono due cose incompatibiliSenza dati, il modello riempie i buchi
1. L'accesso alla posta era scaduto, e doveva scadere
L'assistente legge posta e calendario con un'autorizzazione di Google. L'applicazione che avevo registrato era rimasta in stato di prova, "Testing" nella console, e in quello stato Google fa scadere l'autorizzazione dopo sette giorni. Non era un guasto: era il comportamento previsto.
I miei appunti dicevano "il token si rinnova da solo, nessun intervento necessario". Vero per il token che dura un'ora. Falso per quello che serve a rinnovarlo, che era quello che moriva. Era già successo la settimana prima: avevo rifatto l'accesso ed era ripartito tutto, per altri sette giorni esatti.
2. Lo script che parla con Google era stato riscritto a metà
Il file che l'assistente usa per leggere posta e calendario pesava 4 KB invece di 43. In fondo c'era un commento in inglese: il resto della logica è stato omesso per brevità, la versione completa è nel repository.
Non era un file troncato. Era un file riscritto da un modello durante una sessione di lavoro della sera prima: aveva copiato con cura l'intestazione e sostituito tutto il resto con un rimando. Un riassunto al posto del programma.
L'aggiornamento automatico di quella mattina non l'ha riparato, e per un motivo sensato: Hermes Agent, lo strumento su cui gira l'assistente, non sovrascrive i file che l'utente ha modificato. Solo che una corruzione, vista da fuori, è identica a una personalizzazione.
3. Le istruzioni chiedevano due cose incompatibili
In cima alle istruzioni del riepilogo c'era una regola, in maiuscolo: mai restituire una risposta vuota. In fondo ce n'era un'altra: se un dato non è disponibile scrivilo, non inventare mai.
Finché tutto funziona le due regole convivono senza problemi. Quando le fonti non rispondono si contraddicono, e il modello ha scelto quella che veniva prima ed era scritta più forte.
Le istruzioni in conflitto si risolvono nel modo peggiore.
Il momento in cui contano è esattamente il momento in cui si contraddicono.
Perché non me ne sono accorto
Questa è la parte che conta più dei guasti.
- Il riepilogo arrivava tutte le mattine. Un messaggio ben formattato, con le sue sezioni al loro posto, non ha l'aspetto di un guasto
- Lo stato dell'esecuzione diceva "ok", anche per i riepiloghi inventati da cima a fondo
- Controllavo che l'output ci fosse, non cosa c'era dentro. Il giorno prima avevo scritto nei miei appunti "ultima esecuzione verificata, esito ok". Avevo verificato che il file esistesse. Dentro, l'assistente diceva di non riuscire ad accedere a Google
- I dati falsi erano plausibili. Una mail su quel servizio è esattamente il tipo di mail che ricevo davvero
Un crash si nota. Una lista di mail inventate no.
Tutti i controlli che avevo verificavano la presenza di qualcosa: il file c'è, il lavoro è partito, l'assistente ha risposto. Nessuno guardava il contenuto. Un servizio che risponde non è un servizio che funziona.
Il moltiplicatore: il modello sbagliato per quel lavoro
Per risparmiare avevo messo come modello principale cohere/north-mini-code:free, un modello gratuito pensato per scrivere codice, a fare un lavoro che di codice non ha niente: leggere posta, calendario e attività, e riassumerli. Il risparmio stimato era di circa 4,50 dollari al mese.
Quella stessa mattina, dopo aver riparato le fonti, ho fatto girare lo stesso identico riepilogo su deepseek/deepseek-v4-flash.
| north-mini-code, ore 06:07 | deepseek-v4-flash, ore 12:19 | |
|---|---|---|
| Posta non letta | 2 mittenti inventati | 1 mail, vera |
| Attività aperte | 16 su 28, le altre tagliate senza dirlo | 28 su 28 |
| Anomalie di un altro sistema | 2 righe identiche, duplicate | 5 anomalie distinte, con data e causa |
Sulla posta il confronto non è alla pari: alle 06:07 l'accesso era rotto, e il primo modello non aveva niente da leggere. Sulle altre due righe sì: quelle fonti funzionavano in tutti e due i casi, e la differenza è tutta del modello.
Lo stesso modello, quando gli ho chiesto in chat di cercare quella mail, ha risposto per quattro volte senza eseguire niente. A un certo punto mi ha chiesto quale servizio di posta usassi. Lo aveva nella propria configurazione.
Un modello non adatto non produce errori, produce risultati verosimili.
Trasformava guasti silenziosi in dati falsi, e questo rende il risparmio un falso risparmio. Non è una critica a quel modello, che fa un altro mestiere. L'errore era mio: averlo messo a fare questo.
Cosa ho cambiato
- Il modello:
deepseek/deepseek-v4-flashcome principale,openai/gpt-oss-120b:freecome riserva - L'accesso: applicazione portata in produzione sulla console di Google, così l'autorizzazione non scade più ogni sette giorni
- Lo script: ripristinato dalla copia buona
- Le istruzioni: via la regola "mai vuoto". Un blocco senza dati ora dice "non disponibile" e il motivo
- Il rilevamento: un controllo che parte prima del riepilogo, tutte le mattine
L'ultimo è il pezzo che conta. È volutamente uno script e non un agente: non interpreta e non riassume, quindi non può raccontare un esito diverso da quello vero. Se è tutto a posto tace. Controlla tre cose, una per ogni guasto di quel giorno, e la prima la controlla facendo una chiamata vera al servizio, non guardando se le credenziali esistono.
Le sei regole che uso da allora
Nei mesi dopo ho scritto una decina di controlli come quello. Rileggendo i casi in cui avevano fallito ho trovato sempre le stesse quattro forme: verificavano la presenza invece dello stato, rilevavano senza riparare, tacevano quando erano loro a rompersi, e quello che girava non corrispondeva più a quello che avevo scritto. Da lì sono uscite sei regole.
1. Controlla lo stato, non la presenza
La domanda è "può fare il suo lavoro?", non "risponde?". Un controllo che può riuscire mentre la funzione è rotta non è un controllo di quella funzione. Il mio, sulle credenziali, passava anche a credenziali revocate: guardava se il file c'era.
2. Ripara da solo, se la riparazione è sicura e si può annullare
Per settimane un avviso mi ha detto "riprova a mano". Se l'unica azione che un avviso suggerisce è una che lo script poteva fare da solo, quella è la riparazione. Con due condizioni: una copia di quello che c'era prima, e mai cancellare.
3. Parla in due casi soli
Ha riparato: una riga, con l'indizio su cosa aveva rotto. Non può riparare: una riga con l'azione esatta da fare, non un consiglio generico. Il silenzio vuol dire una cosa sola: ho controllato ed era tutto a posto.
4. "Non ho potuto controllare" non deve sembrare "ok"
Si riprova, e se non passa lo si dice. E mai un'azione distruttiva su un errore passeggero: un mio controllo cancellava le credenziali a ogni verifica fallita, comprese quelle fallite perché in quel momento non c'era rete.
5. Si deve poter provare senza toccare la cosa vera
Un controllo il cui guasto è il silenzio va messo davanti a una rottura finta, in tutti i suoi rami, prima di fidarsi del suo silenzio. Altrimenti stai solo sperando.
6. Quello che gira deve essere quello che è scritto
Una copia sola del controllo, sotto controllo di versione, e da lì arriva dove deve girare. E un controllo che ha qualcosa da dire non è un controllo fallito: se il sistema tratta ogni suo messaggio come un errore, in una settimana smetti di leggerli.
Se hai un agente AI che lavora per te, o per il tuo team
Cinque domande. Se a una non sai rispondere, è lì che guarderei.
- I tuoi controlli guardano il contenuto, o solo che qualcosa sia arrivato?
- Quando una fonte non risponde, l'agente lo dice o riempie il buco? Provalo: stacca una fonte e guarda cosa scrive
- Le istruzioni reggono quando qualcosa si rompe? Cerca le coppie che si contraddicono sotto guasto, come "rispondi sempre" e "non inventare"
- Il modello è stato scelto per il lavoro, o per il prezzo?
- Chi controlla l'agente è un altro modello? Allora può sbagliare nello stesso modo. Un controllo vero è uno script che non ha niente da interpretare
Che un modello inventi non si elimina del tutto. Quello che si può fare è costruire le cose in modo che, quando succede, te ne accorgi tu. E prima di chi riceve il risultato.
Se stai mettendo in piedi qualcosa di simile e vuoi confrontarti, scrivimi.
Domande frequenti
Perché l'AI inventa le risposte?
Un modello linguistico produce il testo più plausibile, non il testo vero. Finché ha i dati davanti, le due cose coincidono quasi sempre. Quando i dati mancano e le istruzioni lo spingono a rispondere comunque, riempie il buco con qualcosa di verosimile. Nel mio caso ha preso il nome di un servizio dalle proprie istruzioni e ci ha costruito intorno una mail.
Le allucinazioni dell'AI si possono evitare?
Del tutto no. Si possono rendere molto più rare: dando al modello i dati invece di lasciarglieli immaginare, togliendo le istruzioni che lo obbligano a rispondere sempre, scegliendo un modello adatto al lavoro. Quello che si può fare davvero è costruire i controlli in modo che quando succede te ne accorgi.
Come ci si accorge che un agente AI sta inventando?
Non leggendo l'output, che è plausibile per costruzione. Ci si accorge controllando le fonti: l'agente ha potuto davvero leggere quello che dice di aver letto? Serve un controllo separato, che non sia a sua volta un modello, e che verifichi lo stato delle fonti con una chiamata vera prima che l'agente lavori.
Un modello più costoso inventa di meno?
Conta più che sia adatto al lavoro. Io avevo messo un modello gratuito pensato per scrivere codice a riassumere posta e calendario, per risparmiare circa 4,50 dollari al mese. Sullo stesso identico lavoro un altro modello ha riportato 28 attività su 28 invece di 16, senza inventare niente.
Cosa vuol dire human in the loop?
Vuol dire che una persona approva prima che un'azione dell'AI abbia effetto. Funziona per le azioni: pubblicare, inviare, pagare. Non basta per le informazioni: un riepilogo falso ma plausibile supera l'approvazione di chiunque, perché chi lo legge non ha modo di sapere che è falso. Lì servono controlli sulle fonti.
Cosa sono i guardrail per un agente AI?
Sono i limiti e i controlli messi intorno a un agente: cosa può fare, cosa deve chiedere, cosa viene verificato prima e dopo. I più utili non stanno nelle istruzioni date al modello, che il modello può ignorare, ma fuori: script e regole che girano comunque, qualunque cosa il modello decida.
Holti Bitri
CTO & AI Innovator, TIG Factory. Progetto e guido flussi in cui agenti AI e persone costruiscono software insieme: regole scritte, un controllo a ogni passaggio, decisioni umane. LinkedIn · holtibitri.com