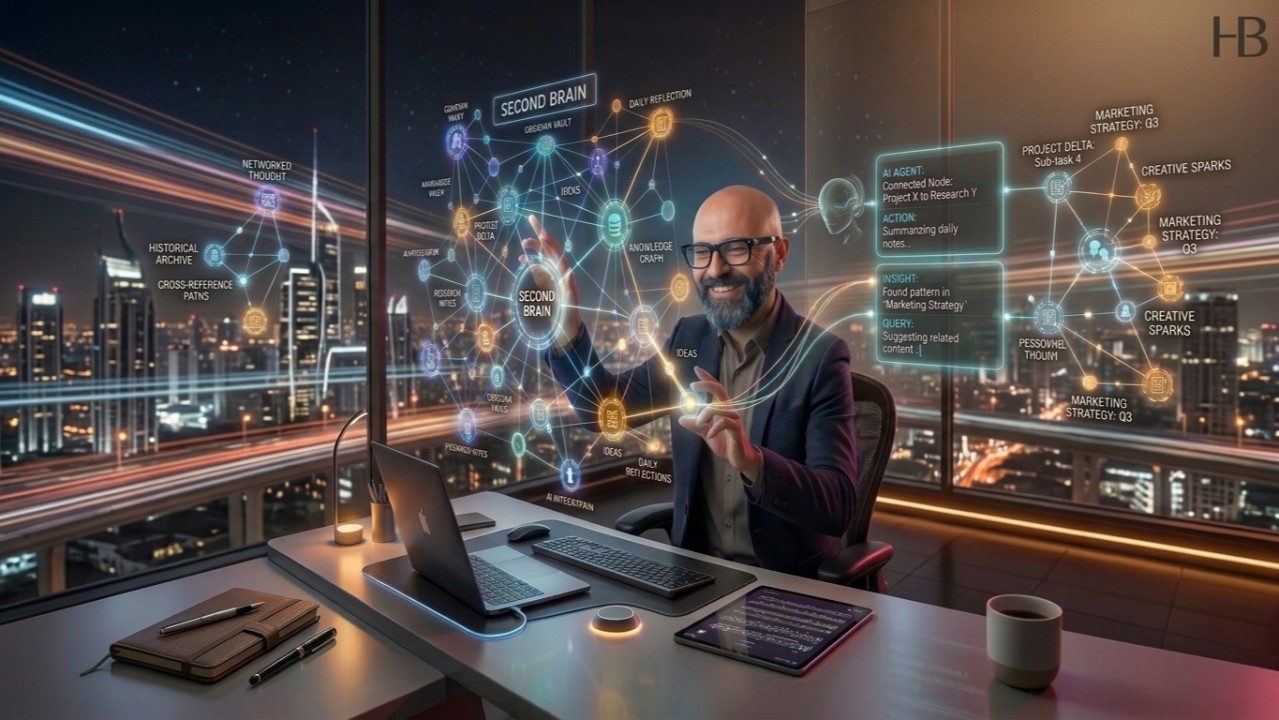
Il problema non era prendere appunti
Non stavo cercando l'ennesimo strumento per le note. Il problema era un altro, e lo sentivo ogni giorno: ogni volta che apro una chat con un modello devo ricominciare da zero. Chi sono. Cosa sto costruendo. Come ragiono. Cosa ho gia' provato e perche' non ha funzionato.
Andrej Karpathy ha dato un nome alla cosa che serve per uscirne: LLM wiki. Un sistema di conoscenza persistente su di te, che l'AI puo' consultare come contesto invece di chiedertelo ogni volta.
La differenza con una cartella di note e' sostanziale. Una cartella di note serve a rileggere. Una LLM wiki serve a essere interrogata, anche da una macchina. E questo cambia come la costruisci.
La regola che regge tutto: ogni informazione ha una sola casa
E' l'unico principio davvero rigido di tutto il sistema, ed e' anche l'unico che non si puo' negoziare quando la vault cresce.
La mia e' divisa in aree, e ognuna risponde a una domanda diversa: il lavoro e i clienti, i progetti attivi, l'identita' professionale, il contesto esterno su aziende e persone, le idee, i contenuti, la vita personale. Ogni cosa che entra ha una destinazione sola, e se ne ha due significa che una delle due e' sbagliata.
Sembra pedanteria. Non lo e', ed ecco perche': quella rigidita' elimina una micro-decisione che altrimenti paghi venti volte al giorno. "Dove lo metto?" ripetuto venti volte al giorno e' il vero costo di attrito, molto piu' della scrittura in se'. Se la risposta e' sempre automatica, smetti di pensarci e inizi a scrivere.
Il corollario che fa male: se la stessa informazione compare in due pagine, una delle due e' gia' obsoleta e non lo sai ancora. Da li' in poi il sistema inizia a mentirti, e la colpa non e' della memoria.
Il bibliotecario non e' un prompt, e' un contratto
La vault non la mantengo a mano. C'e' un agente che ci lavora dentro, e la cosa che ha fatto la differenza non e' stato scrivere un prompt migliore: e' stato scrivere un documento.
Nella radice della vault c'e' un file di regole che l'agente carica automaticamente all'inizio di ogni sessione. Non dice "aiutami con le note". Dice, per iscritto e una volta sola:
- come si crea una pagina e come si collega alle altre
- le convenzioni di naming dei file
- dove va ogni tipo di informazione, area per area
- cosa l'agente non tocca senza autorizzazione esplicita
- quali sono i checkpoint in cui deve fermarsi e chiedere
La differenza rispetto a un prompt e' tutta qui: non stai chiedendo un'opinione, stai applicando regole scritte una volta sola. Un prompt lo riscrivi ogni volta e ogni volta esce leggermente diverso. Un contratto lo correggi quando sbaglia, e la correzione vale per sempre.
Cosa fa da solo
Con quel contratto in piedi, tre cose succedono senza che io le guidi:
- Appunti da una call: crea la pagina, collega le persone e le aziende citate, aggiorna la panoramica dell'area toccata
- Chiusura di sessione: scrive un diario con una struttura fissa, cosa e' stato fatto, cosa e' rimasto aperto, quali decisioni sono state prese e perche'
- Documento nuovo: capisce dove va, lo collega a quello che esiste gia', aggiorna gli indici
Il risultato onesto: cosa e' cambiato e cosa no
Parto da quello che non e' cambiato, perche' e' la parte che di solito nessuno racconta. Non sono diventato piu' veloce con le mail. Non svuoto la lista dei task prima di sera. Il tempo che ho non e' aumentato di un minuto.
Quello che e' cambiato e' un'altra cosa. Entro in una riunione e so esattamente a che punto siamo su un progetto: non perche' ho una memoria straordinaria, ma perche' tre giorni fa ho scritto perche' avevamo preso quella decisione. E quando riapro una sessione con l'agente, l'AI riparte da dove l'avevo lasciata, perche' il contesto e' gia' scritto. Niente rispiegami-tutto-da-capo.
Non sono diventato piu' produttivo. Sono diventato piu' chiaro. Sono due cose diverse: la produttivita' e' una quantita', la chiarezza e' una qualita', e a distanza di mesi so quale delle due mi mancava davvero.
Perche' funziona: context engineering, non prompt engineering
Qui sta il cambio di paradigma, e vale la pena dirlo in una riga sola: un prompt migliore aiuta una volta, un contesto migliore aiuta ogni volta dopo.
La vault non e' un archivio passivo da cui ogni tanto ripesco qualcosa. E' la memoria che do al modello prima che mi risponda. Il prompt engineering risolve la domanda che sto facendo adesso. Il context engineering risolve il prossimo anno di domande, perche' ogni sessione parte da un sistema che gia' sa chi sono, cosa sto costruendo e cosa ho gia' scartato.
Il dietro le quinte tecnico
La parte che nei post non entrava mai, e che e' quella che la gente poi chiede.
Runtime e regole
L'agente gira su Claude Code, che lavora sui file invece che in una chat. Il file di regole sta nella radice della vault e viene caricato a ogni avvio: e' il contratto di cui sopra, ed e' l'unico posto dove le regole vivono.
Le due skill che uso ogni giorno
/avvia-sessione: legge il contesto del progetto, cerca le sessioni precedenti, presenta un briefing aggiornato prima che io abbia scritto una riga/chiudi-sessione: scrive il diario del giorno con una struttura fissa e aggiorna l'indice delle sessioni
Sono comandi banali. Il valore non e' nel comando, e' nel fatto che la struttura del diario e' sempre la stessa, quindi fra sei mesi si puo' ancora leggere.
Obsidian per pensare, Notion per tracciare
Non tutto sta nella vault, e non deve. I dati strutturati che cambiano stato, i KPI dei contenuti, le candidature, i task aperti, vivono su Notion; e' l'agente a tenere allineate le due parti. Obsidian e' il posto dove si pensa, Notion e' il posto dove si traccia, e confondere i due ruoli e' il modo piu' veloce per avere due sistemi che si contraddicono.
Metadati, altrimenti il grafo e' decorazione
Ogni pagina ha un frontmatter YAML obbligatorio: tipo di pagina, area, tag, data di ultimo aggiornamento, fonti da cui viene la conoscenza. Serve a una cosa sola ma importante: rendere il sistema interrogabile e non solo leggibile. Con i metadati il grafo dei collegamenti diventa utile. Senza, e' un poster.
Fonti canoniche fuori dalla vault
Le date degli appuntamenti non si scrivono nelle pagine. Si crea l'evento sul calendario e nella pagina va il link. Sembra un dettaglio ed e' la regola che evita il lavoro peggiore di tutti, cioe' aggiornare a mano la stessa data in quattro posti e scoprire che in uno e' rimasta vecchia.
Un lint, perche' altrimenti marcisce
C'e' uno script Python che passa la vault e cerca: frontmatter mancante o incompleto, link interni rotti, pagine che nessuno collega, pagine diventate troppo lunghe, parti del grafo scollegate dal resto. Lo lancio prima delle sessioni lunghe. E' gratis e oggettivo, e trova sistematicamente cose che io non vedo piu' perche' ci lavoro dentro tutti i giorni.
Per iniziare non serve tutto questo
Serve pochissimo, e conviene partire piccoli: la regola della casa unica e due o tre aree vere, non sette perfette. Il resto si aggiunge quando serve davvero.
Una struttura progettata in anticipo descrive il lavoro che immagini di fare, non quello che fai. La mia e' cambiata parecchie volte, e ogni cambiamento e' arrivato da un attrito reale, mai da una pianificazione.
Dove va a finire
Il passo successivo e' stato smettere di leggere la vault e iniziare a farla agire: un agente personale che usa quella conoscenza non per rispondere in generale, ma per agire in contesti che conosce, con regole che ho scritto io, su dati che sono miei. Ma quella e' un'altra storia, ed e' anche piu' lunga.
Domande frequenti
Che differenza c'e' fra un secondo cervello e una cartella di note?
Una cartella di note serve a rileggere. Una LLM wiki serve a essere interrogata, anche da un modello. La differenza pratica sta in tre cose: ogni informazione ha una sola casa, ogni pagina porta metadati strutturati, e le regole di manutenzione sono scritte in un file invece che ricordate.
Serve per forza Obsidian?
No. Serve che le pagine siano file di testo semplice su disco, con metadati leggibili e link fra loro. Obsidian e' comodo perche' e' solo un lettore sopra una cartella di Markdown: se domani cambi strumento i file restano tuoi e l'agente continua a leggerli.
Come fa l'AI a leggere la vault?
Si punta un agente che lavora su file, come Claude Code, alla cartella della vault. Nella radice c'e' un file di regole che viene caricato a ogni sessione e dice all'agente com'e' fatta la struttura, dove va ogni cosa e cosa non deve toccare senza permesso.
Quanto tempo serve per costruirla?
Poco per partire e molto per finirla, ed e' il motivo per cui conviene non finirla. Bastano la regola della casa unica e due o tre aree vere; il resto si aggiunge quando serve, perche' una struttura progettata in anticipo descrive il lavoro che immagini, non quello che fai.
Qual e' la differenza fra prompt engineering e context engineering?
Un prompt migliore aiuta una volta. Un contesto migliore aiuta ogni volta dopo. Il prompt risolve la domanda che stai facendo, il contesto risolve il prossimo anno di domande, perche' il modello parte gia' sapendo chi sei, cosa stai costruendo e cosa hai gia' provato.
Cosa succede quando la vault cresce e si sporca?
Serve un controllo automatico, altrimenti marcisce. Uno script che cerca frontmatter mancante, link rotti, pagine senza nessun collegamento in entrata e pagine troppo lunghe, eseguito prima delle sessioni lunghe, tiene il sistema leggibile senza doverci pensare.
Holti Bitri
CTO & AI Innovator, TIG Factory. Quasi vent'anni nell'ecosistema Microsoft, oggi fra architetture cloud, pipeline AI in produzione e il mestiere di capire quando un modello sta sbagliando senza dirtelo. LinkedIn · holtibitri.com